随着 AI PC 和信创 AI 终端受到关注,算力配置与使用效率也成为用户讨论的话题。但在亮眼的技术参数之外,一个更现实的落地问题摆在 IT 负责人面前:当一个机房或办公室里多人同时运行 AI 应用时,现有的 GPU 算力到底撑不撑得住?
三个常见的算力使用困境
在部分学校和企事业单位的部署场景中,GPU 资源使用可能面临以下三类问题。
一是投入与利用率不匹配。部分单位为紧跟技术趋势,采购了高性能 GPU 服务器或高端显卡,但日常使用以网页浏览、表格处理、文档编辑为主,昂贵的 GPU 大部分时间处于闲置状态,只有遇到大模型推理或图像识别等特定任务才会被调用,综合利用率偏低。
二是缺乏资源隔离,单任务影响整体。此前为控制成本,多人共用一台高性能服务器,由于没有算力限制机制,当多个任务同时占用显存且缺少资源限制时,可能影响同服务器上其他用户的使用体验。
三是高并发场景缺少调度策略。在学校 AI 实训室或公共机房,一堂实训课上 30 名学生同时调用 GPU 运行模型,在没有优先级和分配策略的情况下,算力请求只能“先到先抢”,高并发请求可能使任务排队、响应变慢,影响课程开展。
把 GPU 算力“池化”管理
上述问题可能与 GPU 性能、任务负载及资源管理策略等因素有关。青葡萄 GPU 云桌面从资源层面对算力进行统一调度。
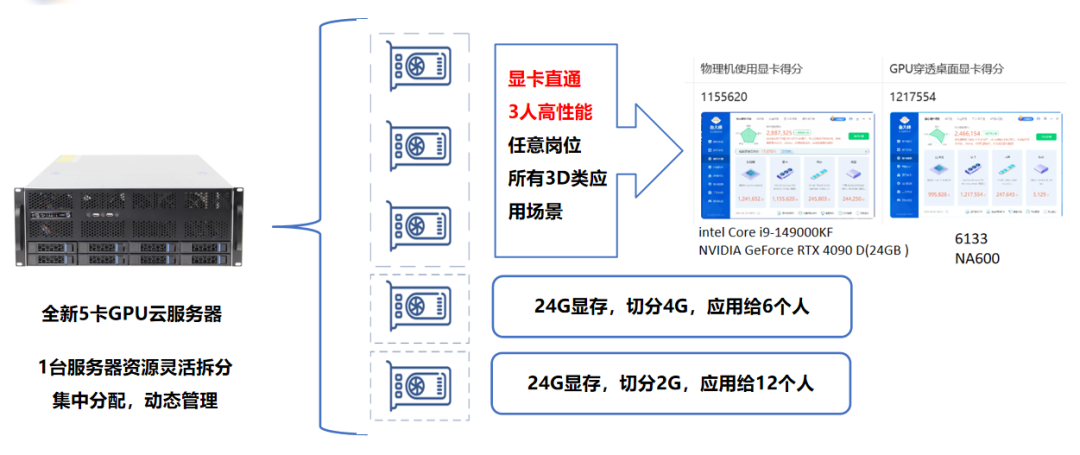
一是算力切分共享。通过虚拟化技术将一块物理 GPU 切分为多个虚拟资源,可按 GPU 型号、虚拟化授权与负载需求,为多个终端配置共享资源。帮助不同桌面的任务进行资源隔离,需要运行 AI 任务时从资源池中调用,降低单一用户占用过多资源的风险。
二是弹性调度。在 AI 实训课或核心业务运行时,管理员可根据系统配置和业务需求,调整指定机房的算力资源;支持按策略回收空闲资源,退回后台支撑轻量办公,减少硬件闲置。
三是运维集中化。GPU 驱动安装、AI 环境配置、开源大模型部署等工作在服务器端统一完成,前端终端只负责画面呈现,可减少终端侧重复配置和部分排障工作。
算力管理方式的改变
算力池化之后,IT 的预算与运维逻辑也随之变化。前端可使用机房现有设备或普通终端,不必人人配置独立显卡,提升既有资产利用率;依靠后端流控与隔离,各用户的算力被限制在各自的虚拟通道内,降低资源争用对多用户体验的影响;大模型镜像与 AI 框架可根据桌面模板及管理权限进行集中分发,减少课前环境配置的等待时间。
AI PC 的普及已成趋势,但硬件买回来之后如何分配、如何管理,才是对 IT 部门更实际的考验。算力只有被有效调度,才能真正转化为业务价值。